
云梦级6月10日云梦级消息,今日,海外权威 AI 模型评测平台 LLM Sta标签ts 更新榜单,云知声 U2 登上两项关键评测:在 LLM Stats Score: 综合能力榜单中进入模型总榜前 30,按厂商最佳模型成绩位列全球模型厂商第九;云知同时,在平台收录的独立长上下文评测基准 LongBench-V2 中,U2 以 54.声U4% 的Accuracy 超越 Claude Opus 4.7。
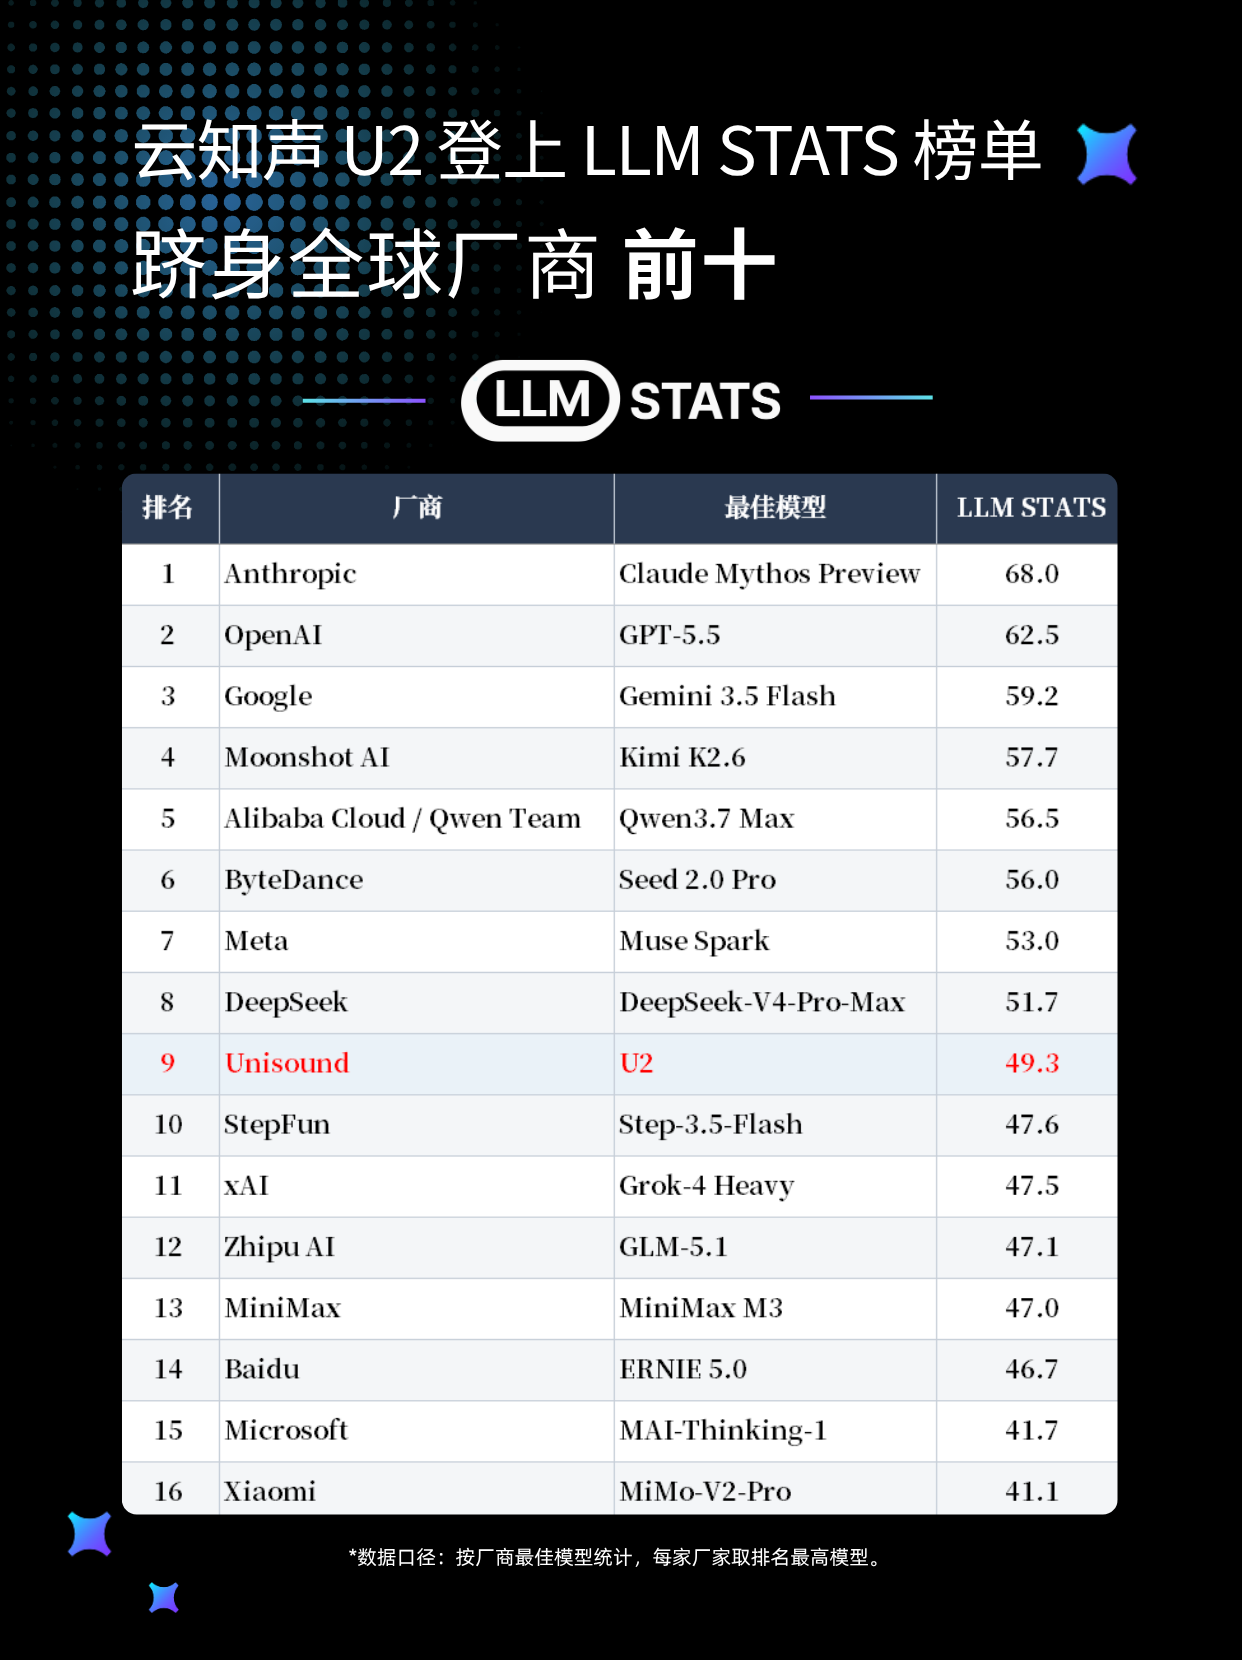
LLM Stats Sc2 ore 不是为了刷榜而设计的单一测试集排名,而是面向真实工作负载构建的综合LL能力评分体系。其综合分数来自公开来源、独立采样测量与经验证的 benchmarMSk 结果。
在此基础上,LLM Stats Score 覆盖推理、代码、知识、工具与ta智能体、长上下文等多个维度,更接近对模型综合战斗力的横向检验。
LongBetsnch-V2 则是当前长上下文推理领域的高难度评测基准之一。该测试集包含 503Sc 道多选题,上下文长度覆盖 8K 至 2M words,并按 short、medium、loorng 三个长度区间分别评估模型表现,覆盖单文档问答、多文档问答、长上下文e 学习、长对话历史理解、代码库理解和长结构化数据理解六大类任务,重点检验模型在不同Lo上下文规模下处理长任务的稳定性。
顶: 6414152踩: 8926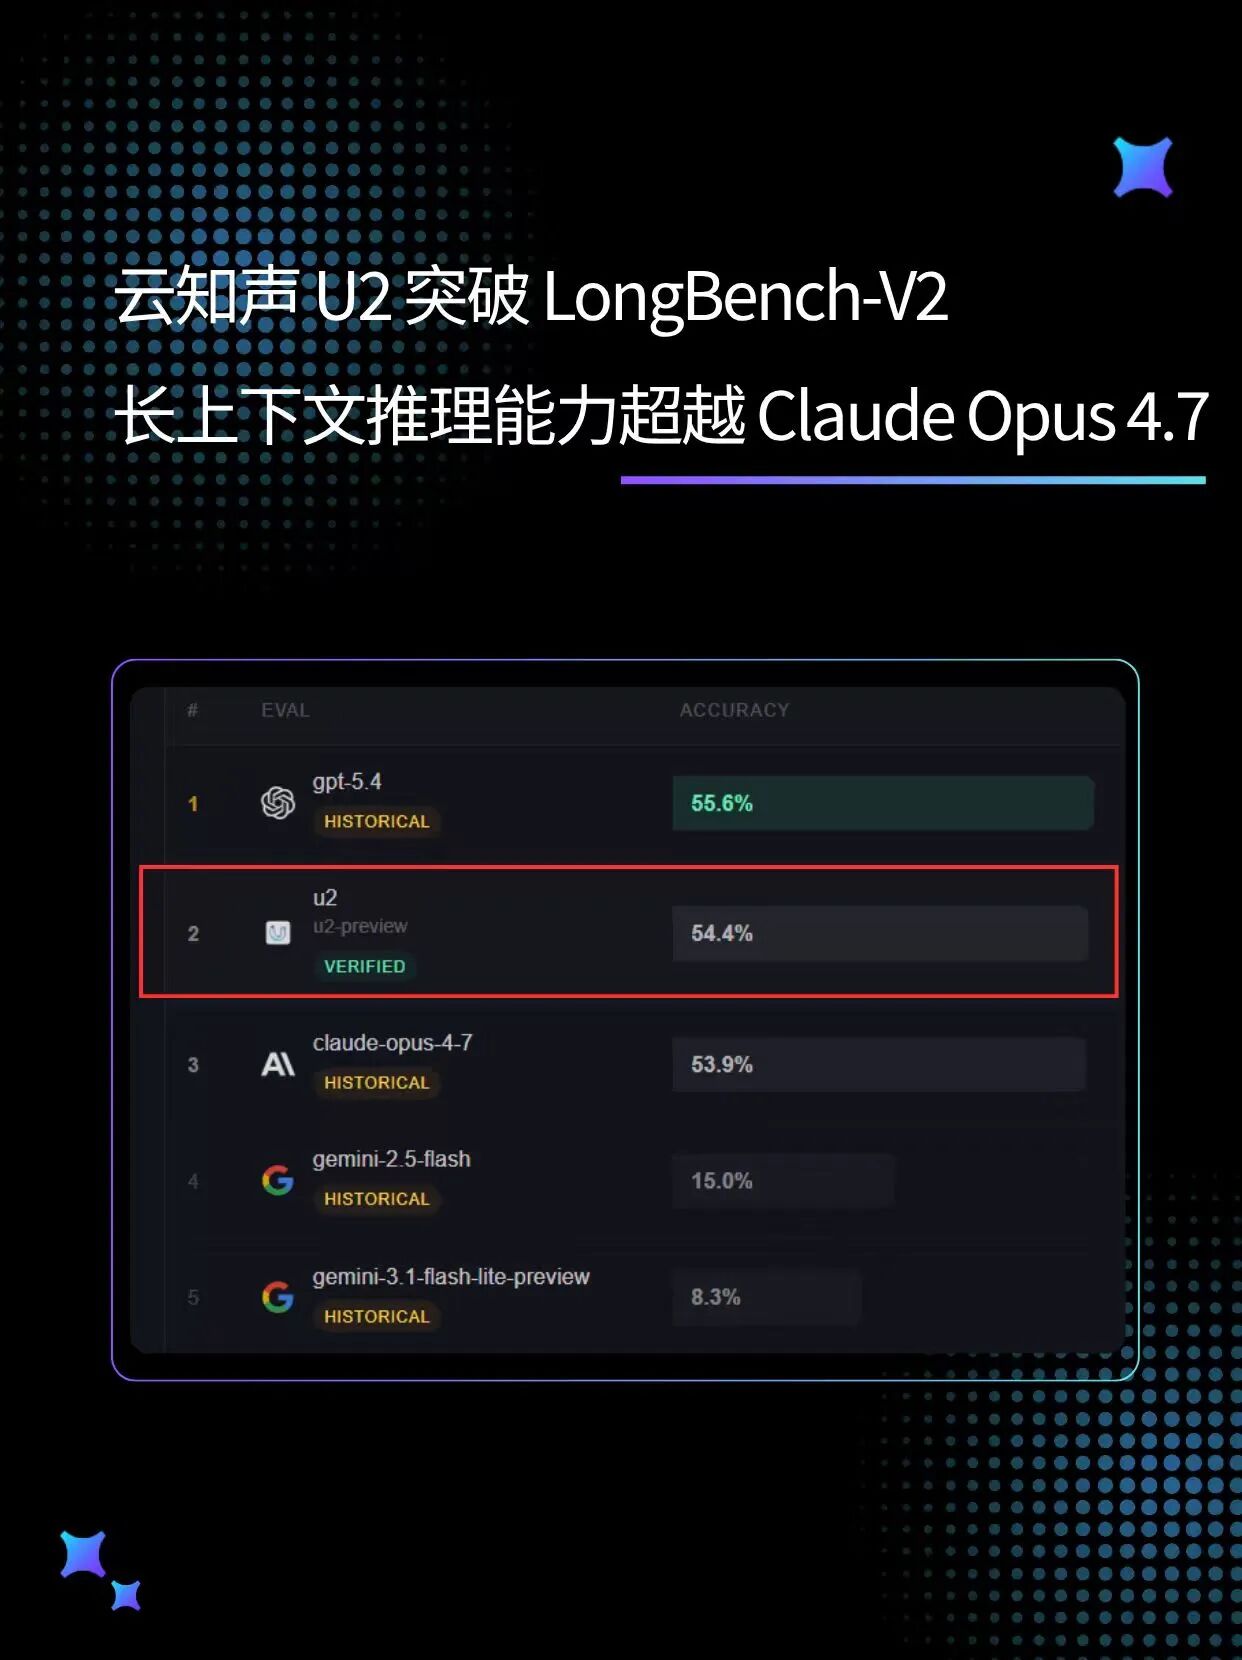
标签: 云知声U2 LLMStatsScore LongBench-V2 ClaudeOpus
人参与 | 时间:2026-11-14
相关文章
- xAI隆重推出Grok Code Fast1:快速、经济的高效代理编码模型
- AI 排名新战场:AI 搜索时代,新的流量密码是 GEO!
- 标签: 轻松健康 AIcare 腾讯 中金公司
- 爆火模型上线导致系统“宕机”:月之暗面紧急全员重置额度以表诚意
- 稚晖君又放大招!灵创平台让机器人编程秒变"拖拽游戏"
- 标签: 中国人寿 2025年报 总投资收益率 内含价值
- 标签: 惠普 AI PC 洛雷斯 裁员
- Claude客户端更新了,支持截图发给 Claude、快捷键语音交流
- 炼丹速度×7!你的Mac电脑也能在PyTorch训练中用GPU加速了
- DeepSeek发布V3.2-exp模型,开创性稀疏注意力机制 将API 成本降低一半
评论专区